Chapter 4 · leçon 3 sur 8
L'architecture des codes d'échec dans Maximo Manage est conçue pour capturer des informations détaillées et structurées sur les défaillances des actifs et des emplacements. Cette structure hiérarchique permet non seulement d'enregistrer un événement de défaillance, mais aussi d'en analyser les causes profondes et les solutions apportées, ce qui est fondamental pour les stratégies de fiabilité.
Au cœur de cette architecture se trouve la hiérarchie de défaillance, qui est construite du niveau supérieur vers le niveau inférieur. Elle commence par une classe de défaillance générale, puis se ramifie en problèmes spécifiques, en causes potentielles et enfin en remèdes. Cette granularité assure que chaque incident est documenté de manière exhaustive, facilitant ainsi les analyses ultérieures et l'amélioration continue des processus de maintenance.

La hiérarchie des codes d'échec est un outil puissant pour structurer les informations sur les défaillances. Chaque niveau apporte une couche de détail supplémentaire, permettant une analyse fine des événements et une meilleure compréhension des problèmes récurrents.
| Niveau | Description | Exemple | Impact sur la fiabilité |
|---|---|---|---|
Failure Class | Catégorie générale de la défaillance. C'est le point de départ de la hiérarchie. | "Mécanique", "Électrique", "Opérationnel" | Permet une vue d'ensemble des types de pannes dominants. |
Problem | Description spécifique du symptôme ou du problème observé. | "Surchauffe du moteur", "Court-circuit", "Erreur de manipulation" | Identifie les manifestations directes des défaillances. |
Cause | Raison fondamentale ou déclencheur de la défaillance. | "Lubrification insuffisante", "Câblage défectueux", "Formation inadéquate" | Crucial pour l'analyse des causes racines (RCA) et la prévention. |
Remedy | Action corrective ou solution appliquée pour résoudre le problème. | "Remplacer le roulement", "Réparer le circuit", "Reprogrammer l'automate" | Documente les solutions efficaces et les meilleures pratiques. |
La création et la gestion des codes d'échec dans Maximo Manage sont des étapes fondamentales pour établir un système robuste de suivi des défaillances. Le processus implique la définition de classes de défaillance, de problèmes associés, de causes potentielles et de remèdes, le tout organisé dans une structure hiérarchique cohérente.
Pour créer une hiérarchie de défaillance, les utilisateurs naviguent généralement vers l'application dédiée aux codes d'échec. La première étape consiste à définir la classe de défaillance, qui est le niveau le plus élevé. Ensuite, des problèmes spécifiques sont ajoutés sous cette classe, suivis des causes possibles pour chaque problème, et enfin des remèdes pour chaque cause. Cette approche garantit une documentation complète et une traçabilité des incidents.
Failure Class et Failure Class Description pour établir la catégorie principale de la défaillance.Problem et sa description. Chaque classe de défaillance peut avoir plusieurs problèmes associés.Work Order Tracking) ou de rapports rapides (Quick Reporting) pour documenter les défaillances observées.Un exemple concret pourrait être la création d'une Failure Class "Électrique". Sous cette classe, on pourrait trouver un Problem "Court-circuit". Les Causes associées pourraient être "Câblage défectueux" ou "Surcharge du circuit". Enfin, les Remedys pourraient inclure "Remplacer le câblage" ou "Installer un disjoncteur adapté". Cette structure permet de capturer l'intégralité du cycle de vie d'une défaillance.
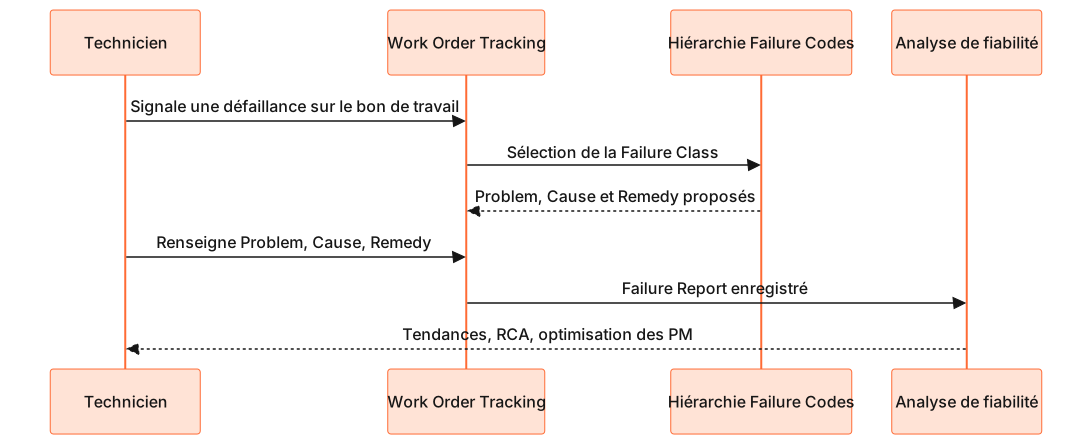
Le workflow de gestion des défaillances dans Maximo est un processus structuré qui commence par la détection d'un problème et se termine par l'analyse des données pour améliorer la fiabilité. L'utilisation des codes d'échec est intégrale à chaque étape, assurant une documentation cohérente et exploitable.
Ce processus permet non seulement de résoudre les problèmes immédiats, mais aussi de collecter des données précieuses qui alimenteront les stratégies de maintenance préventive et prédictive. En documentant systématiquement les défaillances, les organisations peuvent identifier les tendances, les actifs problématiques et les causes racines, conduisant à des améliorations significatives de la performance opérationnelle.
Un piège courant est de ne pas bien distinguer les rôles de Failure Class, Problem, Cause et Remedy. Par exemple, un utilisateur pourrait enregistrer "Surchauffe du moteur" comme une Failure Class au lieu d'un Problem sous une Failure Class plus générale comme "Mécanique". Cela conduit à une hiérarchie plate, moins utile pour l'analyse des causes racines et la génération de rapports significatifs. Il est crucial de maintenir la structure hiérarchique pour une efficacité maximale.
Sans une formation adéquate ou des directives claires, les techniciens peuvent utiliser des descriptions variées pour des problèmes similaires, ou choisir des codes d'échec inappropriés. Par exemple, une "Vibration excessive" pourrait être enregistrée sous "Mécanique" par un technicien et sous "Opérationnel" par un autre. Cette incohérence rend les données de défaillance peu fiables pour l'analyse des tendances et l'optimisation des stratégies de maintenance. Une gouvernance stricte et une formation continue sont essentielles.
Certaines organisations créent des codes d'échec mais ne les intègrent pas pleinement dans leurs programmes de fiabilité comme le RCM (Reliability Centered Maintenance) ou le FMEA (Failure Modes and Effects Analysis). Les données collectées via les codes d'échec sont une mine d'informations pour identifier les modes de défaillance critiques, évaluer l'efficacité des tâches de maintenance préventive et justifier les investissements en amélioration. Ne pas exploiter ces données revient à manquer une opportunité majeure d'optimisation.
Une hiérarchie trop complexe avec trop de niveaux ou des descriptions trop détaillées peut décourager les utilisateurs et ralentir la saisie des données. À l'inverse, une hiérarchie trop simple ou générique ne fournira pas suffisamment de détails pour une analyse pertinente. L'équilibre est clé : la hiérarchie doit être suffisamment détaillée pour être utile, mais assez simple pour être facilement adoptée et utilisée par les équipes de maintenance sur le terrain. Une révision périodique est recommandée pour ajuster la granularité.
L'objectif principal est de structurer et de standardiser l'enregistrement des défaillances des actifs et des emplacements. Cela permet une analyse approfondie des causes racines, l'identification des tendances de pannes, et l'optimisation des stratégies de maintenance pour améliorer la fiabilité des équipements.
Les quatre niveaux principaux sont : Failure Class (classe de défaillance générale), Problem (problème spécifique ou symptôme), Cause (raison fondamentale de la défaillance), et Remedy (action corrective appliquée). Ils sont organisés du général au spécifique.
Les codes d'échec fournissent des données empiriques sur les modes de défaillance réels, leurs fréquences et leurs impacts. Ces informations sont essentielles pour les analyses RCM (identification des fonctions critiques et des modes de défaillance) et FMEA (évaluation des risques et des effets des défaillances), permettant de concevoir des plans de maintenance plus efficaces et ciblés.
Une incohérence dans la saisie des codes d'échec rend les données de défaillance peu fiables et difficiles à analyser. Cela peut masquer des tendances réelles, fausser les rapports de fiabilité, et empêcher l'identification précise des problèmes récurrents, compromettant ainsi les efforts d'amélioration continue de la maintenance.
Les codes d'échec sont principalement configurés et gérés dans l'application Failure Codes de Maximo Manage. C'est là que les classes de défaillance, les problèmes, les causes et les remèdes sont définis et structurés en hiérarchies.
 Certavia